Dalam pengembangan arsitektur IoT (Internet of Things) skala industri seperti sistem Smart Grid atau pemantauan konsumsi energi listrik terdapat suatu masalah klasik yang hampir selalu menjadi tantangan untuk tim engineering adalah lonjakan volume data telemetri.
pada awal pengembangan dengan device yang masih kecil jumlahnya, mungkin arsitektur masih terasa ringan setiap kali device mengirimkan paket data setiap 5 detik ke backend. Namun ketika sistem berkembang menjadi besar ke tingkat produksi dengan ratusan atau ribuan device yang aktif masalah mulai bermunculan, seperti Utilisasi disk IOPS menyentuh 100%, Kapasitas penyimpanan database membengkak, Proses VACUUM dan pembaruan indeks di PostgreSQL memakan CPU secara masif, dan Query dashboard untuk menampilkan grafik historis menjadi sangat lambat dan terjadi timeout.
Dalam artikel ini saya akan mengulas studi kasus dari arsitektur backend Go pada project Smart KWH yang saya kerjakan dan memecahkan masalah tersebut melalui Tiered Storage Architecture, In-Memory Bucketing, Automated Lifecycle Retention, dan Hybrid Runtime Configuration.
Mengapa menyimpan semua data RAW adalah Anti-Pattern?
Menyimpan semua data raw telemetry ke database memang terlihat aman karena setiap data dari device IoT tersimpan lengkap. Namun, ketika jumlah device bertambah dan interval pengiriman semakin pendek, volume data akan tumbuh dengan sangat cepat.
Sebagai contoh, 500 perangkat RTU yang mengirim data setiap 5 detik menghasilkan sekitar 8,64 juta baris per hari atau 259,2 juta baris per bulan. Dengan asumsi ukuran 150 byte per baris, kebutuhan penyimpanan mencapai sekitar 38,9 GB per bulan, belum termasuk overhead dan indeks database.
Masalahnya, tidak semua data mentah perlu disimpan selamanya. Real-time dashboard cukup membutuhkan data terbaru, sedangkan laporan konsumsi energi dapat menggunakan agregasi harian atau bulanan. Untuk analisis tren, data juga bisa diringkas ke interval 1 menit, 5 menit, atau 1 jam.
Karena itu, menyimpan semua data RAW tanpa strategi retensi dan agregasi dapat menjadi anti-pattern. Salah satu solusinya adalah menerapkan dynamic in-memory aggregation untuk mengolah data telemetri di memori sebelum menyimpan hasil agregasinya ke database. Dengan cara ini, beban penulisan dan kebutuhan penyimpanan dapat dikurangi tanpa menghilangkan informasi yang relevan.
Strategi Dual Tier Storage
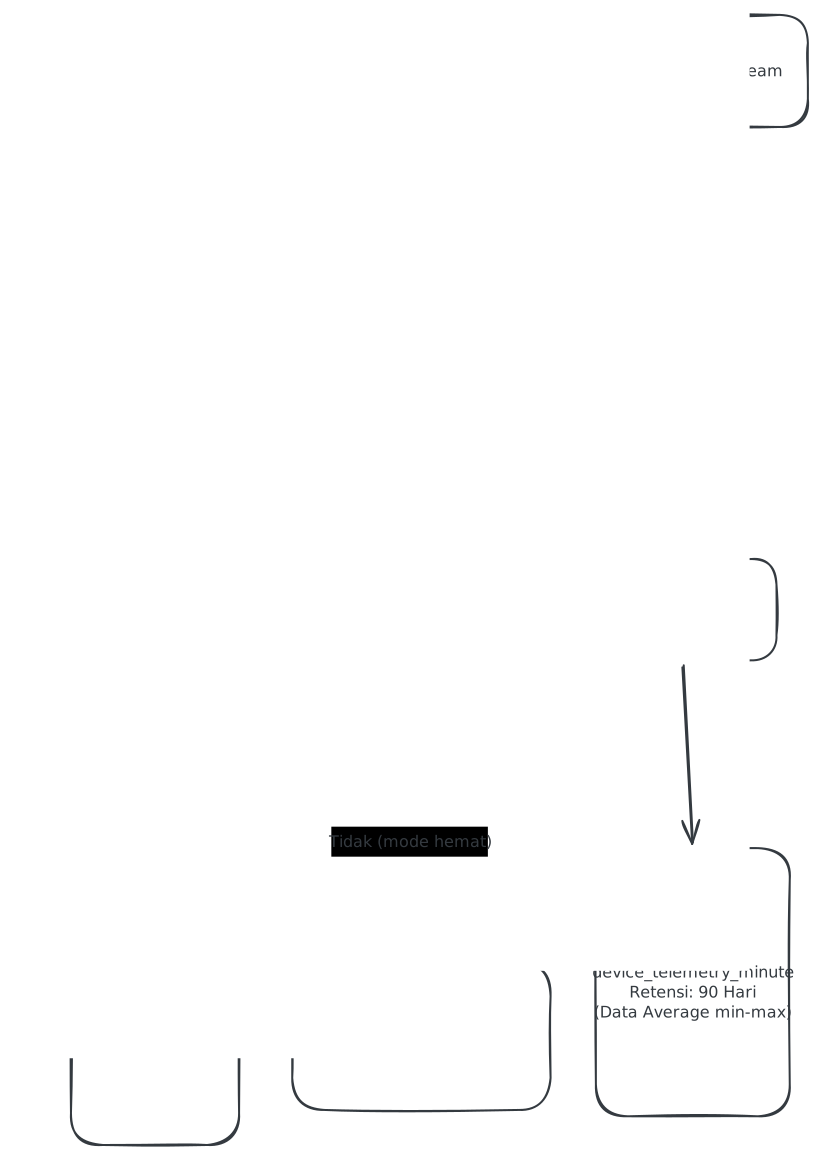
Pada sistem ini, data dari device IoT dikirim setiap 5 detik melalui Ingestion Gateway, kemudian diteruskan ke NATS JetStream untuk diproses oleh Go Consumer Worker. Dari sini, data dibagi sesuai kebutuhan, yaitu untuk monitoring real-time melalui WebSocket dan penyimpanan ke database.
Kita menggunakan dua lapisan penyimpanan. Pertama, RAW Storage, yang menyimpan data telemetri secara lengkap dengan retensi 14 hari untuk kebutuhan debugging dan investigasi. Mode ini bisa diaktifkan ketika diperlukan. Jika mode hemat aktif, penulisan data mentah ke database dilewati untuk mengurangi beban I/O.
Kedua, Aggregated Storage, yang mengumpulkan data di memori dan menghitung nilai rata-rata, minimum, serta maksimum per menit sebelum menyimpannya ke tabel device_telemetry_minute. Data agregasi ini disimpan selama 90 hari agar tetap bisa digunakan untuk analisis tren tanpa harus mempertahankan seluruh data mentah.
Dengan pendekatan ini, sistem tetap mendukung monitoring real-time dan kebutuhan debugging, sekaligus mengurangi beban database serta penggunaan storage.
Karakteristik Setiap Tier Penyimpanan
| Kriteria | Raw Telemetry | Aggregated Telemetry |
| Frekuensi data | Data instan setiap 5–10 detik | Data agregasi setiap 1 atau 5 menit |
| Isi data | Nilai aktual data | Rata-rata data |
| Retensi | 14 hari | 90 hari |
| Kegunaan | Debugging dan investigasi masalah teknis di lapangan | Analisis tren, grafik historis, serta perhitungan biaya listrik harian dan bulanan |
| Dampak storage | Membutuhkan ruang penyimpanan lebih besar | Lebih hemat karena jumlah baris data jauh lebih sedikit |